Introduction au web scraping python et à la bibliothèque Beautiful Soup
Objectif
Apprendre à extraire des informations d’une page html à l’aide de python et de la bibliothèque Beautiful Soup.
Exigences
- Compréhension des bases de python et de la programmation orientée objet
Conventions
- # – nécessite que la commande linux donnée soit exécutée avec les privilèges root, soit
directement en tant qu’utilisateur root, soit en utilisant la commandesudo - $ – commande linux donnée à exécuter en tant qu’utilisateur régulier non privilégié
Introduction
Le web scraping est une technique qui consiste à extraire des données d’un site web grâce à l’utilisation d’un logiciel dédié. Dans ce tutoriel, nous allons voir comment effectuer un web scraping de base à l’aide de python et de la bibliothèque Beautiful Soup. Nous utiliserons python3 ciblant la page d’accueil de Rotten Tomatoes, le célèbre agrégateur de critiques et d’actualités pour les films et les émissions de télévision, comme source d’information pour notre exercice.
Installation de la bibliothèque Beautiful Soup
Pour effectuer notre grattage, nous allons utiliser la bibliothèque python Beautiful Soup, donc la première chose que nous devons faire est de l’installer. La bibliothèque est disponible dans les dépôts de toutes les principales distributions GNU\Linux, nous pouvons donc l’installer en utilisant notre gestionnaire de paquets préféré, ou en utilisant pip, la méthode native de python pour installer les paquets.
Si l’utilisation du gestionnaire de paquets de distribution est préférée et que nous utilisons Fedora :
sudo dnf install python3-beautifulsoup4Sur Debian et ses dérivés, le paquet s’appelle beautifulsoup4 :
sudo apt-get install beautifulsoup4Sur Archilinux, nous pouvons l’installer via pacman :
sudo pacman -S python-beatufilusoup4Si nous voulons utiliser pip, à la place, nous pouvons simplement exécuter :
pip3 install --user BeautifulSoup4En exécutant la commande ci-dessus avec l’indicateur --user, nous installerons la dernière version de la bibliothèque Beautiful Soup uniquement pour notre utilisateur, donc aucune autorisation root n’est nécessaire. Bien sûr, vous pouvez décider d’utiliser pip pour installer le paquet globalement, mais personnellement, j’ai tendance à préférer les installations par utilisateur lorsque je n’utilise pas le gestionnaire de paquets de distribution.
L’objet BeautifulSoup
Commençons : la première chose que nous voulons faire est de créer un objet BeautifulSoup. Le constructeur BeautifulSoup accepte soit une chaîne de caractères, soit un descripteur de fichier comme premier argument. C’est ce dernier qui nous intéresse : nous avons l’url de la page que nous voulons scraper, nous allons donc utiliser la méthode urlopen de la bibliothèque urllib.request (installée par défaut) : cette méthode retourne un objet de type fichier :
from bs4 import BeautifulSoup
from urllib.request import urlopen

with urlopen('http://www.rottentomatoes.com') as homepage:
    soup = BeautifulSoup(homepage)
À ce stade, notre soupe c’est prêt : l’objet soupe représente le document dans son intégralité. Nous pouvons commencer à le parcourir et à extraire les données que nous voulons à l’aide des méthodes et des propriétés intégrées. Par exemple, supposons que nous voulions extraire tous les liens contenus dans la page : nous savons que les liens sont représentés par la balise a en html et que le lien réel est contenu dans l’attribut href de la balise, nous pouvons donc utiliser la méthode find_all de l’objet que nous venons de construire pour accomplir notre tâche :
for link in soup.find_all('a'):
    print(link.get('href'))
En utilisant la méthode find_all et en spécifiant a comme premier argument, qui est le nom de la balise, nous avons recherché tous les liens de la page. Pour chaque lien, nous avons ensuite récupéré et imprimé la valeur de l’attribut href. Dans BeautifulSoup, les attributs d’un élément sont stockés dans un dictionnaire, il est donc très facile de les récupérer. Dans ce cas, nous avons utilisé la méthode get, mais nous aurions pu accéder à la valeur de l'attribut href même avec la syntaxe suivante : link['href']. Le dictionnaire d’attributs complet lui-même est contenu dans la propriété attrs de l’élément. Le code ci-dessus produira le résultat suivant :
[...]
https://editorial.rottentomatoes.com/
https://editorial.rottentomatoes.com/24-frames/
https://editorial.rottentomatoes.com/binge-guide/
https://editorial.rottentomatoes.com/box-office-guru/
https://editorial.rottentomatoes.com/critics-consensus/
https://editorial.rottentomatoes.com/five-favorite-films/
https://editorial.rottentomatoes.com/now-streaming/
https://editorial.rottentomatoes.com/parental-guidance/
https://editorial.rottentomatoes.com/red-carpet-roundup/
https://editorial.rottentomatoes.com/rt-on-dvd/
https://editorial.rottentomatoes.com/the-simpsons-decade/
https://editorial.rottentomatoes.com/sub-cult/
https://editorial.rottentomatoes.com/tech-talk/
https://editorial.rottentomatoes.com/total-recall/
[...]
La liste est beaucoup plus longue : ce qui précède n’est qu’un extrait de la sortie, mais vous donne une idée. La méthode find_all renvoie tous les objets Tag qui correspondent au filtre spécifié. Dans notre cas, nous avons juste spécifié le nom de la balise qui doit correspondre, et aucun autre critère, donc tous les liens sont renvoyés : nous verrons dans un instant comment restreindre davantage notre recherche.
Un cas d’école : récupérer tous les titres du « Top box-office »
Effectuons un grattage plus restreint. Disons que nous voulons récupérer tous les titres des films qui apparaissent dans la section « Top Box Office » de la page d’accueil de Rotten Tomatoes. La première chose que nous voulons faire est d’analyser le html de la page pour cette section : ce faisant, nous pouvons observer que les éléments dont nous avons besoin sont tous contenus à l’intérieur d’un élément de table avec l’identifiant « Top-Box-Office » :
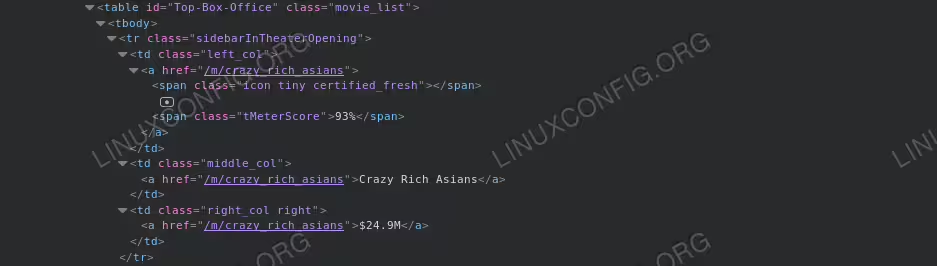
Meilleur box-office
On peut également observer que chaque ligne du tableau contient des informations sur un film : les scores du titre sont contenus sous forme de texte à l’intérieur d’un élément span avec la classe « tMeterScore » à l’intérieur de la première cellule de la ligne, tandis que la chaîne représentant le titre du film est contenue dans la deuxième cellule, comme le texte de l’élément a étiquette. Enfin, la dernière cellule contient un lien avec le texte qui représente les résultats au box-office du film. Avec ces références, nous pouvons facilement récupérer toutes les données que nous voulons :
from bs4 import BeautifulSoup
from urllib.request import urlopen

with urlopen('https://www.rottentomatoes.com') as homepage:
    soup = BeautifulSoup(homepage.read(), 'html.parser')

    # first we use the find method to retrieve the table with 'Top-Box-Office' id
    top_box_office_table = soup.find('table', {'id': 'Top-Box-Office'})

    # than we iterate over each row and extract movies information
    for row in top_box_office_table.find_all('tr'):
        cells = row.find_all('td')
        title = cells[1].find('a').get_text()
        money = cells[2].find('a').get_text()
        score = row.find('span', {'class': 'tMeterScore'}).get_text()
        print('{0} -- {1} (TomatoMeter: {2})'.format(title, money, score))
Le code ci-dessus produira le résultat suivant :
Crazy Rich Asians -- $24.9M (TomatoMeter: 93%)
The Meg -- $12.9M (TomatoMeter: 46%)
The Happytime Murders -- \$9.6M (TomatoMeter: 22%)
Mission: Impossible - Fallout -- $8.2M (TomatoMeter: 97%)
Mile 22 -- $6.5M (TomatoMeter: 20%)
Christopher Robin -- $6.4M (TomatoMeter: 70%)
Alpha -- $6.1M (TomatoMeter: 83%)
BlacKkKlansman -- $5.2M (TomatoMeter: 95%)
Slender Man -- $2.9M (TomatoMeter: 7%)
A.X.L. -- $2.8M (TomatoMeter: 29%)
Nous avons introduit quelques nouveaux éléments, voyons-les. La première chose que nous avons faite, c’est de récupérer la table avec l’identifiant 'Top-Box-Office', en utilisant la méthode find. Cette méthode fonctionne de la même manière que find_all, mais alors que cette dernière renvoie une liste qui contient les correspondances trouvées, ou qui est vide s’il n’y a pas de correspondance, la première renvoie toujours le premier résultat ou None si un élément avec les critères spécifiés n’est pas trouvé.
Le premier élément fourni à la méthode find est le nom de la balise à prendre en compte dans la recherche, en l’occurrence table. Comme deuxième argument, nous avons passé un dictionnaire dans lequel chaque clé représente un attribut de la balise avec sa valeur correspondante. Les paires clé-valeur fournies dans le dictionnaire représentent les critères qui doivent être satisfaits pour que notre recherche produise une correspondance. Dans ce cas, nous avons recherché l’attribut id avec la valeur « Top-Box-Office ». Notez que puisque chaque identifiant doit être unique dans une page html, nous aurions pu simplement omettre le nom de la balise et utiliser cette syntaxe alternative :
top_box_office_table = soup.find(id='Top-Box-Office')
Une fois que nous avons récupéré notre objet Table Tag, nous avons utilisé la méthode find_all pour trouver toutes les lignes et itérer sur celles-ci. Pour récupérer les autres éléments, nous avons utilisé les mêmes principes. Nous avons également utilisé une nouvelle méthode, get_text : elle renvoie uniquement la partie texte contenue dans une balise, ou si aucune n’est spécifiée, dans la page entière. Par exemple, sachant que le pourcentage de musique de film est représenté par le texte contenu dans l’élément span avec la classe tMeterScore, nous avons utilisé la méthode get_text sur l’élément pour le récupérer.
Dans cet exemple, nous avons simplement affiché les données récupérées avec un formatage très simple, mais dans un scénario réel, nous aurions peut-être voulu effectuer d’autres manipulations ou les stocker dans une base de données.
Conclusions
Dans ce tutoriel, nous n’avons fait qu’effleurer la surface de ce que nous pouvons faire en utilisant python et la bibliothèque Beautiful Soup pour effectuer du web scraping. La bibliothèque contient de nombreuses méthodes que vous pouvez utiliser pour une recherche plus affinée ou pour mieux naviguer dans la page : pour cela, je recommande vivement de consulter la documentation officielle très bien écrite.